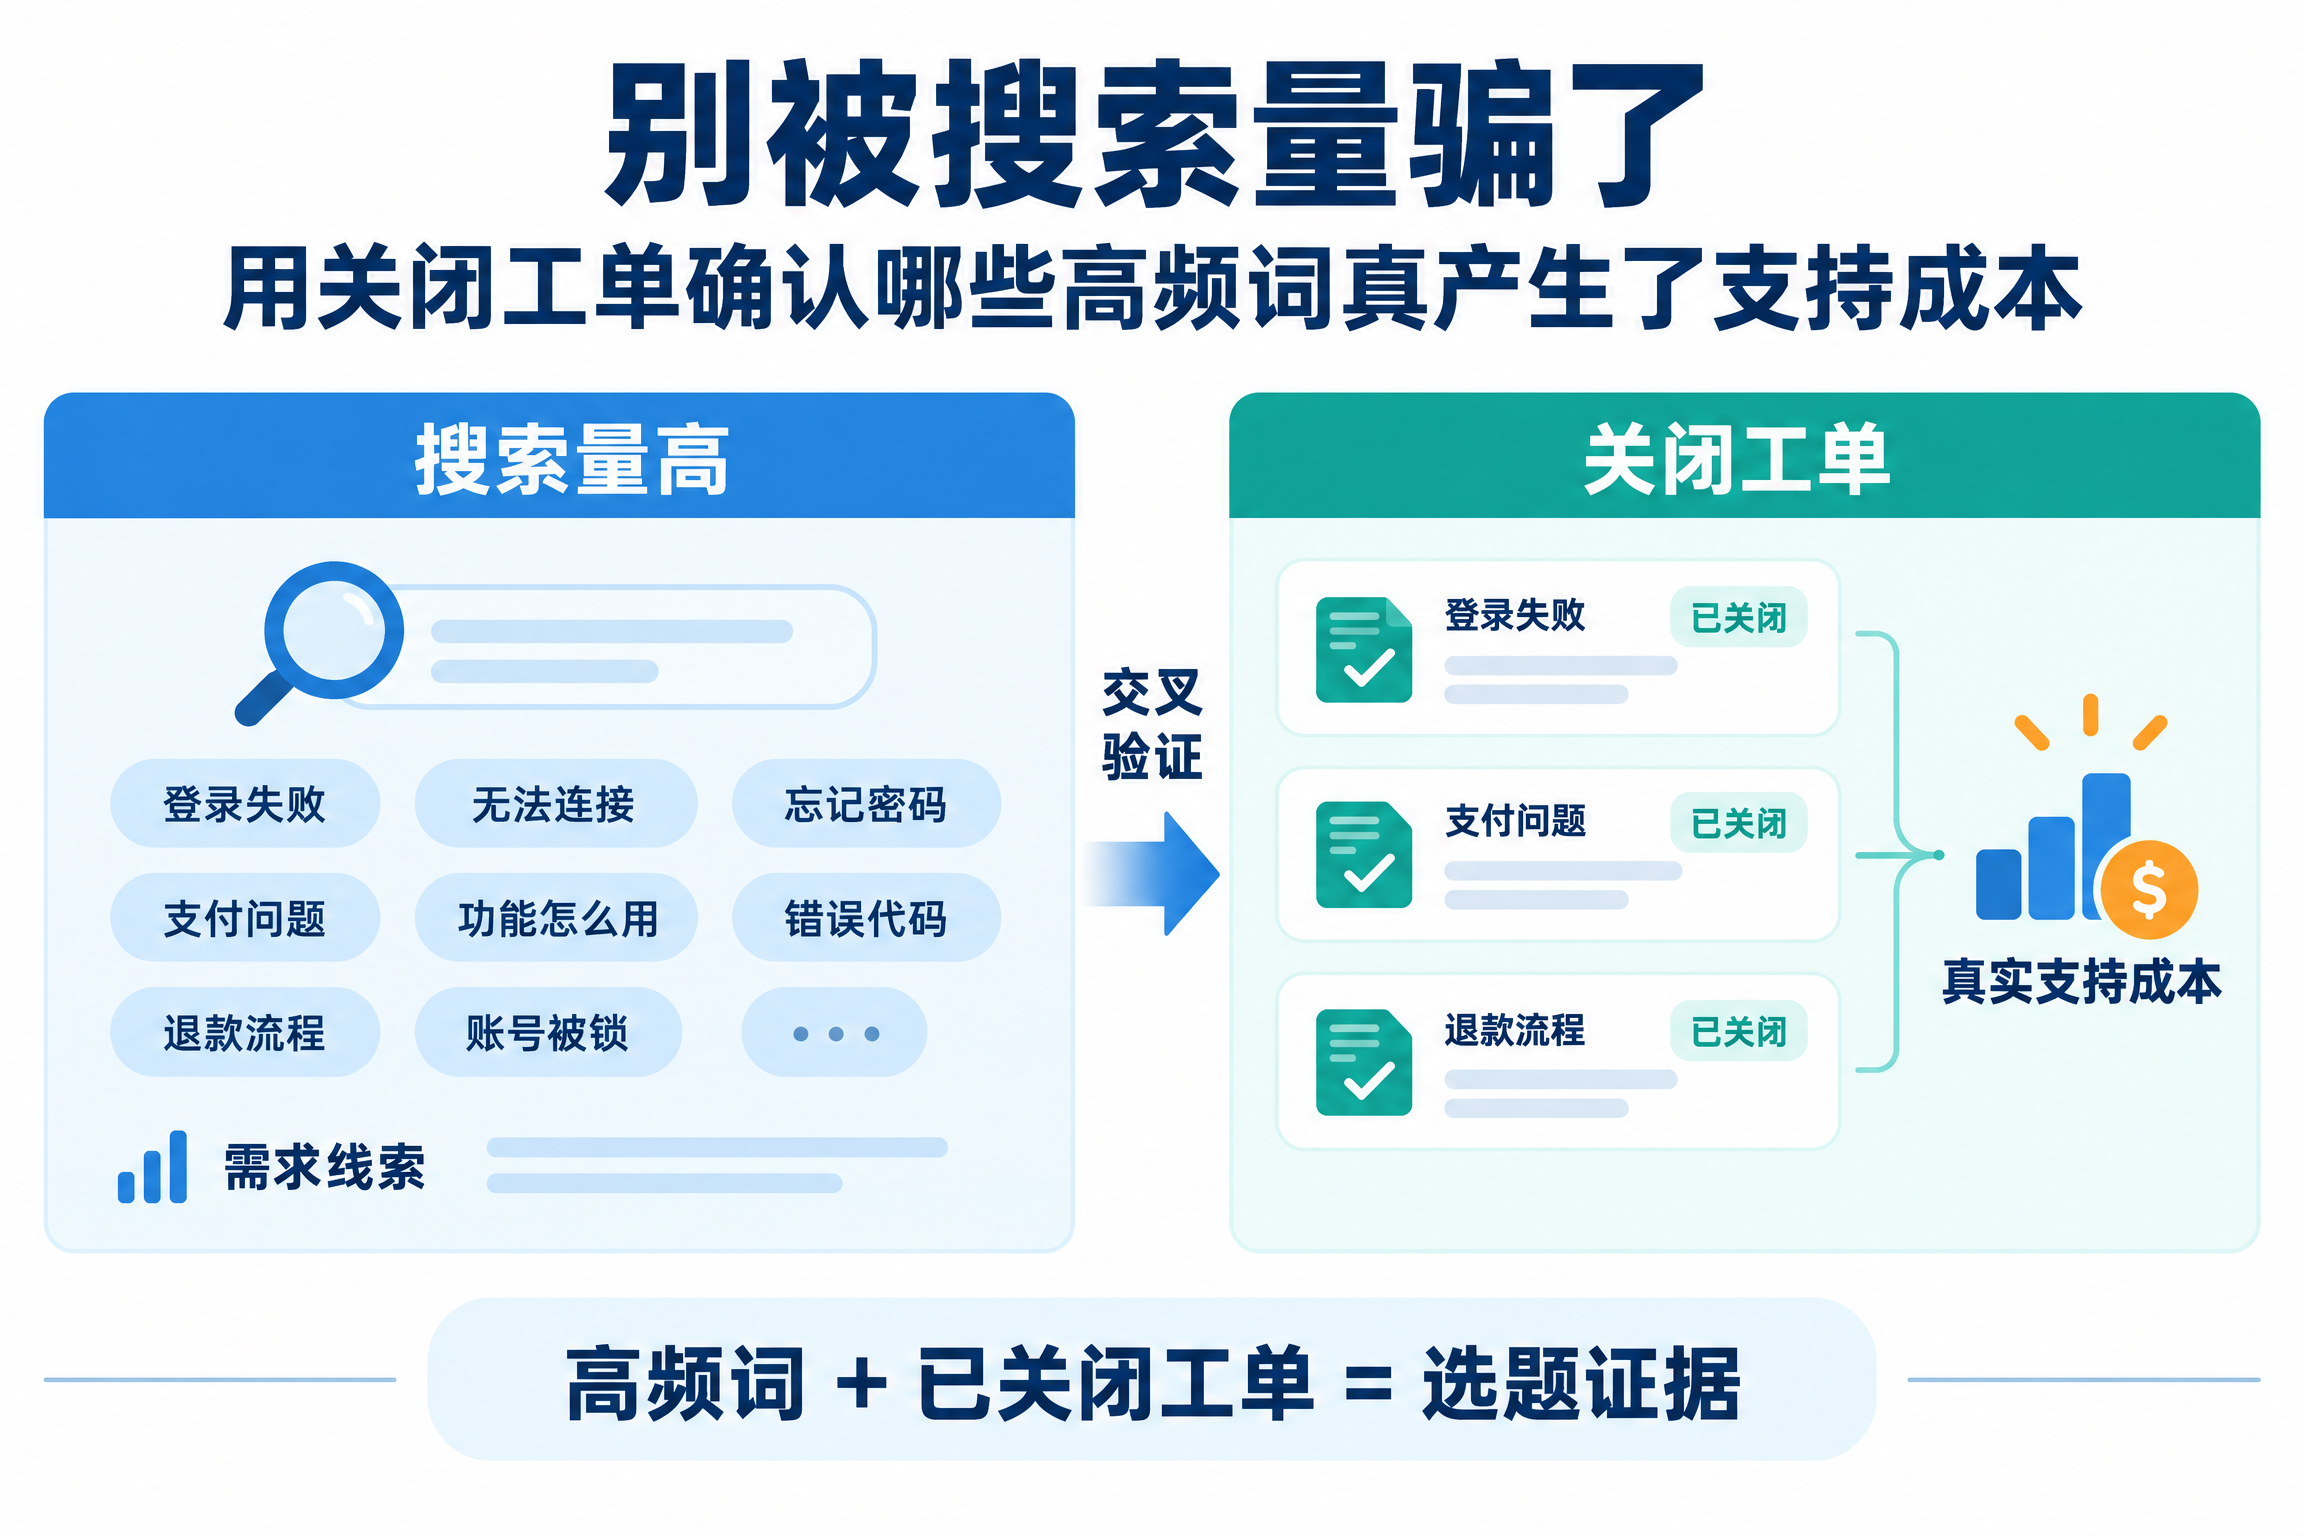
通过交叉分析搜索日志与工单滞后数据,可精准识别高频查询是否真正转化为人工支持成本,从而锁定高价值内容缺口。
如何用搜索日志和客服工单发现高价值内容缺口?
快速答案: 将帮助中心的搜索词、无结果搜索、结果点击等数据,与相近时间段的客服工单主题、处理时长和解决结果交叉分析,可以发现哪些问题既难以自助解决,又持续消耗人工支持资源。但搜索量与工单量的相关性不能直接证明用户为何提交工单;确定选题前,还应抽样阅读工单并检查现有内容及搜索入口。
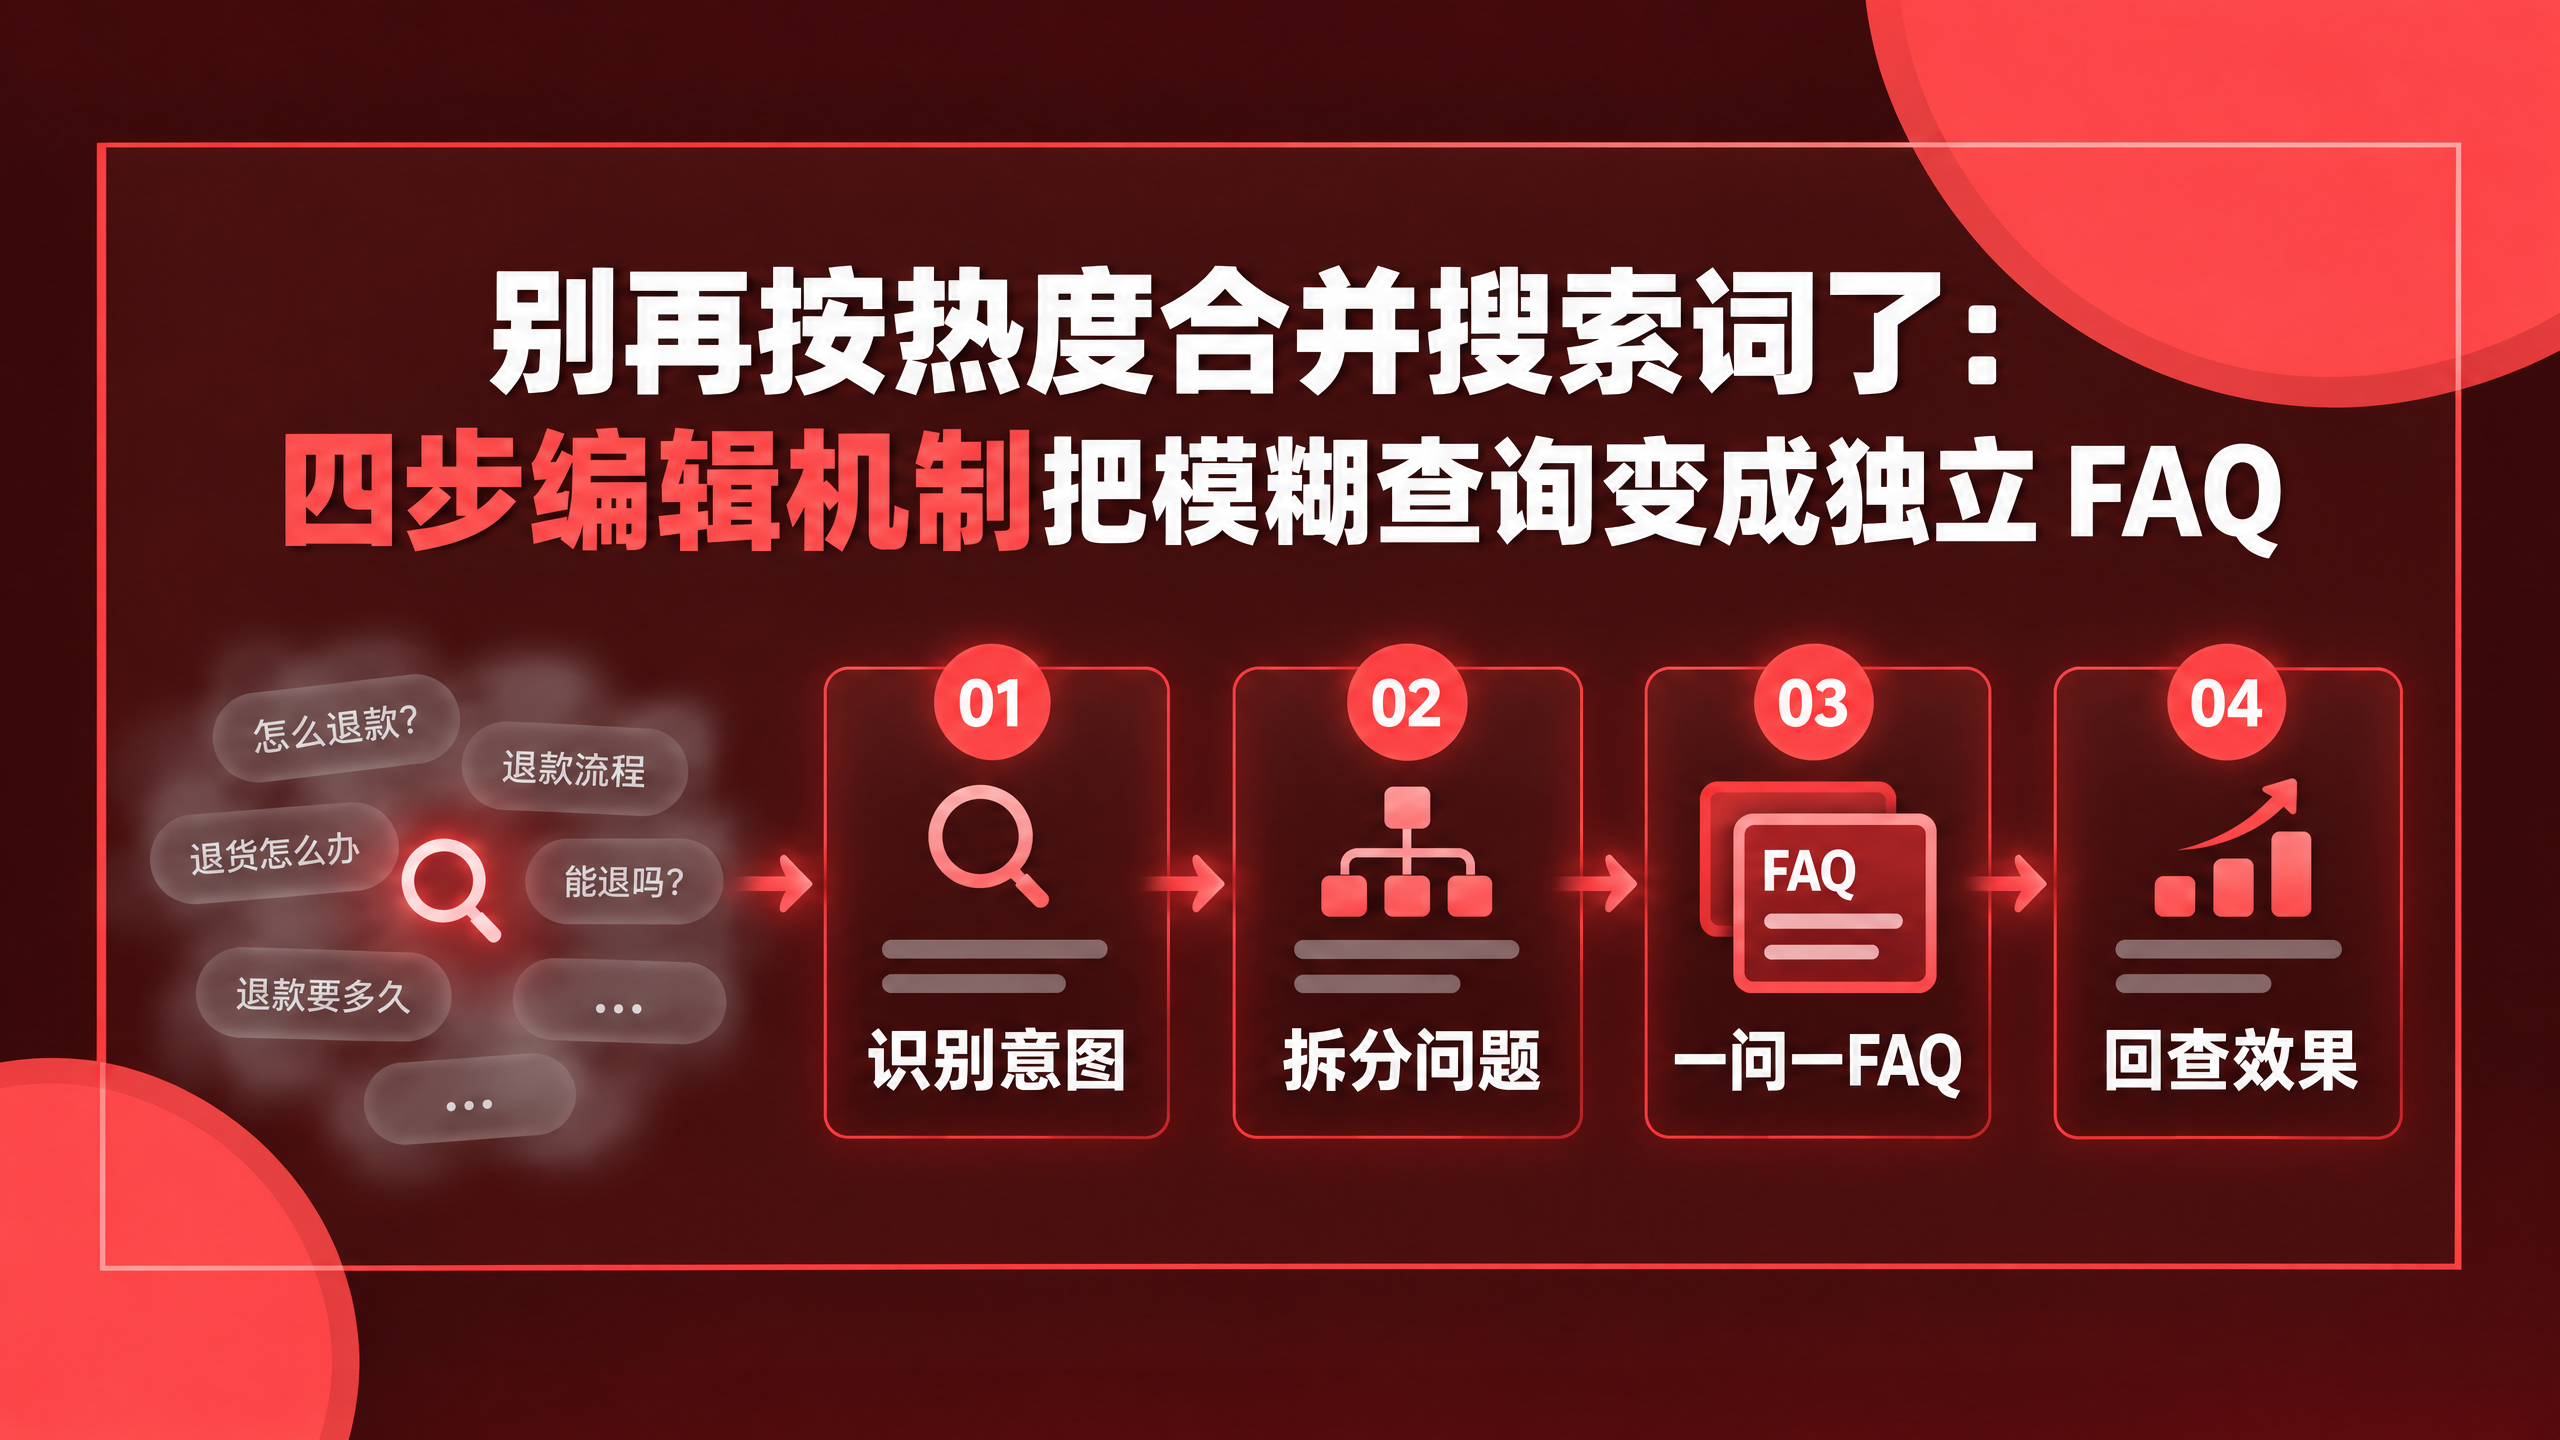
统一问题主题和时间窗口: 将同义搜索词与相关工单归为同一问题,注意工单从创建到解决可能存在时间差。
识别异常组合: 观察高搜索量且高工单量、低搜索量但高处理成本、无结果搜索伴随相关工单等情况。
核实根因: 抽查搜索结果和工单解决记录,判断问题来自内容缺失、标题不匹配、搜索索引、导航入口,还是产品本身的故障。
选择对应措施: 内容缺失才考虑新建 FAQ;已有文章找不到,应先优化标题、同义词和导航;若问题无法自助解决,应改进产品流程或升级支持路径。
发布后验证: 持续观察相关搜索的结果点击、无结果率和工单量,并结合产品变更、流量变化判断措施是否有效。
判断原则: 高价值内容缺口,不是“搜索多”或“工单多”本身,而是一个反复出现、用户难以通过现有内容解决、且有可验证的标准解决方法的问题。
为什么不能只看搜索量?用真实数据锁定“真需求”
仅凭搜索量无法判断真实需求,必须结合工单数据才能区分信息获取型搜索与产生实际支持成本的求助行为。
别被搜索框里跳动的数字骗了。高频查询并不等于用户真的需要人工介入,很多时候只是信息入口没对上,或者摘要已经完美解决了问题。要判断一个话题是否真正产生了支持成本,必须把搜索日志和工单数据结合起来看。单纯依赖搜索量做决策,就像是在雾里开车,容易偏离方向。
搜索日志的盲区:热闹不等于需要人工
单纯依赖搜索日志存在天然盲区。如果一个词搜得再多,却很少转化为工单,它可能已经被系统自动解决,或者用户根本没找到求助按钮 [1]。这种情况下,盲目制作 FAQ 不仅浪费资源,还可能增加用户的阅读负担。只有当困惑真正转化为实际求助时,才意味着产生了需要承担的成本。
工单的核心价值:从“猜测需求”到“确认根因”
客服工单提供了另一种关键证据。在特定研究场景中,工单属于滞后指标,只有在工单关闭后才能收集并分析,平均滞后约为 2 周 [1]。但这正是它的价值所在:关闭的工单往往包含用户上下文、客服判断、解决路径和最终结果,这些信息比裸搜索词更接近问题本质 [1]。
通过双重验证机制,搜索日志捕捉“正在发生的困惑”,而工单则用于确认“困惑是否产生了支持成本、是否已有可验证解决方案”[2]。若一个低频查询反复生成高复杂度工单,它可能比高频低风险问题更值得独立成篇 [3]。
本章检查清单:
[ ] 核对搜索词频率与工单转化率的差异
[ ] 确认工单是否已处于“关闭”状态(确保数据有效)
[ ] 识别“高频低工单”与“低频高工单”两类典型场景
[ ] 优先处理那些产生高复杂度工单的冷门查询
理解工单数据的滞后性:2 周周期的真实含义
工单从提交到关闭存在约两周的周期滞后,这意味着需基于历史数据而非实时状态来制定有效的 FAQ 选题策略。
TicketHub 的研究数据显示,在该特定场景下,从用户提交工单到最终关闭,平均需要经历约 2 周的周期 [1]。这并非所有客服系统的通用铁律,而是该研究摘要中报告的具体事实 [1]。你如果指望用刚提交的工单来立刻决定今天的 FAQ 选题策略,数据会告诉你这是徒劳的。
为什么关闭工单才是可靠的证据?
开放状态的工单往往只是问题的开始,而非终点。只有当工单被标记为“已关闭”,才意味着解决路径完整闭环,解决方案的有效性得到了最终验证 [1]。这种状态包含了用户上下文、客服的判断逻辑以及最终的处置结果,这些细节比单纯的搜索词更接近问题的根因 [1]。相比之下,虽然部分系统提供了实时标签或机器人转人工记录作为早期信号,但现有资料缺乏跨平台的实证材料来证明这些机制能准确反映问题的真实复杂度 [1]。因此,依赖未关闭的工单数据做核心决策风险极高,必须接受关闭工单分析存在约 2 周滞后的现实。
2 周滞后对内容规划节奏的影响
这 2 周的延迟直接定义了工单数据的用途边界:它是趋势复盘的信号,而非实时响应的雷达 [1]。搜索日志适合捕捉“正在发生的困惑”,而工单则负责确认“困惑是否产生了支持成本”以及“是否已有可验证的解决方案”[1][2]。如果你试图用实时的开放工单去预测明天的内容需求,往往会因为信息不全而误判。正确的做法是将工单数据纳入周期性复盘,用来识别重复出现的高复杂度问题,并验证知识库是否存在缺口 [1]。一个低频查询若反复生成高复杂度的已关闭工单,其价值可能远超那些高频却低风险的问题,这才是值得独立成篇的内容缺口 [3][2]。
本章执行检查清单
[ ] 确认数据来源:明确”2 周”是特定研究场景下的统计结果,非通用规律 [1]。
[ ] 筛选有效样本:仅使用状态为“已关闭”的工单进行分析,忽略开放中的工单 [1]。
[ ] 调整使用场景:将工单数据定位为周期性复盘和知识缺口验证工具,不用于实时优先级排序 [1]。
[ ] 对比验证逻辑:结合搜索日志(看热度)与工单(看成本),识别真正值得深入的内容点 [3][2]。
实操三步法:如何识别值得独立成篇的内容缺口
筛选高价值内容缺口的三步法旨在剥离虚假流量,直接定位那些消耗客服资源且必须独立成篇的真实问题。
读完本章,你能直接筛出真正消耗客服资源、必须独立成篇的 FAQ 选题。别被搜索量蒙蔽,跟着这三步走,把工单数据变成精准的内容地图。
第一步:交叉比对高频查询与工单生成率
先拉出高频搜索词列表,再对照同一时间段的工单生成率。如果某个词搜索量巨大但几乎不产生工单,说明用户要么在搜索结果页就解决了问题,要么根本没找到求助入口,这类通常不需要单独写文档 [3][2]。反之,若搜索量中等甚至偏低,却频繁触发工单,这才是真正的“资源黑洞”,必须优先处理。
第二步:重点挖掘“低频高复杂度”工单
把目光锁定那些低频但复杂的工单。这类问题往往代表了用户未被解决的深层困惑,比高频低风险问题更值得投入资源制作独立 FAQ [3][2]。它们通常隐藏在长尾查询里,一旦解决能大幅降低后续重复咨询。
案例拆解:低频高复杂度工单的优先级判定
| 特征维度 | 高频低风险问题 | 低频高复杂度工单 |
|---|---|---|
| 搜索量 | 极高 | 低或中 |
| 工单生成率 | 极低 | 高 |
| 解决成本 | 低(通常自助解决) | 高(需人工介入) |
| 根因性质 | 信息缺失或入口难找 | 逻辑复杂或场景特殊 |
| FAQ 优先级 | 优化搜索摘要即可 | 必须独立成篇 |
数据显示,关闭的工单包含了解决路径和最终结果,比裸搜索词更接近问题根因 [1]。这种深度信息是判断是否值得写长文的关键依据。
如何利用工单分类快速定位知识盲区
利用客服初步分类和机器人转人工原因,能快速发现系统性的知识缺失。TicketHub 相关研究指出,工单数据分析能帮助支持人员识别相似解决方案并捕获更大趋势,进而改进知识库搜索 [1]。不要只看工单标题,要深挖分类标签背后的共性。当多个不同来源的工单都指向同一个模糊的分类时,说明你的内容库在这里存在明显的断层。
实战避坑:新手常误判“搜索无结果”即“无需干预”很多运营新手看到某个长尾词搜索量为零或极低,且没有对应工单,便认为该问题不存在或无需处理。这是一个巨大的误区。如果该关键词在搜索日志中显示“无结果”或“点击后跳出率高”,同时伴随少量工单提及“找不到入口”,这恰恰说明是导航结构或索引配置出了问题,而非用户不需要帮助。此时,仅仅补充一篇 FAQ 是治标不治本,甚至会因为增加了新的页面而进一步稀释流量。正确的做法是:先检查搜索后台的“无结果词”报表,确认该词是否因关键词匹配规则过严而被过滤;如果是,应优先修复搜索索引或添加同义词映射,让系统能自动召回相关内容,从而在源头减少工单产生。这种“修路”比“建亭子”更能从根本上降低支持成本。
第三步:建立验证标准,确认重复性与可标准化特征
最后一步是验证。确认该问题是否具有重复性,以及能否通过标准化的步骤解决。只有具备这两个特征,独立 FAQ 才能发挥最大价值。记住,关闭工单才是可靠的证据,因为它包含了完整的上下文和解决结果,而不仅仅是用户的抱怨 [1]。
本节检查清单
[ ] 筛选出搜索量高但工单少的关键词(排除项)
[ ] 锁定搜索量低但工单多且复杂的关键词(优先项)
[ ] 核对工单分类是否指向同一类系统性盲区
[ ] 确认问题是否具备重复出现和标准化解决的潜力
避坑指南:工单分析中的常见误判与应对策略
避免误判的关键在于拒绝单一数据源,应综合搜索趋势与工单全生命周期状态,而非盲目依赖早期信号或孤立数据。
别急着把没进 FAQ 的工单直接扔进垃圾桶。很多人误以为工单滞后或复杂就意味着“不适合做选题”,这其实是个大错特错。关闭工单确实包含用户上下文和解决路径,比单纯搜索词更接近根因 [1]。但开放工单、实时标签这些早期信号,目前缺乏跨平台实证支持,盲目依赖只会让你跑偏 [1]。更稳妥的策略是拒绝单一数据源,必须把搜索趋势和工单状态结合起来看。
工单的约 2 周滞后期不是缺陷,而是它的天然属性 [1]。在 TicketHub 的研究场景里,只有工单关闭才算完成闭环 [1]。这意味着它不适合作为唯一的实时优先级信号,却极适合用来做趋势复盘、识别重复问题以及验证知识库缺口 [1]。
何时该忽略工单数据?
当你的业务需要实时监控用户体验时,工单数据就该暂时靠边站。如果系统里没有经过实证的早期信号机制(如开放的实时标签),此时应优先参考搜索日志或其他实时指标 [1]。等到工单关闭后,再拿这些数据去修正之前的判断。记住,搜索日志负责捕捉“正在发生的困惑”,而工单负责确认“困惑是否产生了实际成本” [2]。
本章检查清单
[ ] 不将低频高复杂度工单直接判定为无效选题
[ ] 不单独使用工单数据做实时决策
[ ] 建立以“工单关闭”为节点的复盘周期
[ ] 结合搜索趋势交叉验证问题优先级
常见问题解答 (FAQ)
Q: 为什么不能用实时的工单数据来决定当天的 FAQ 选题?A: 因为工单数据具有天然的滞后性(约 2 周)。开放中的工单尚未形成完整的解决闭环,无法准确反映问题的根因和解决成本。实时决策应依赖搜索日志,而工单数据更适合用于周期性的复盘和策略调整。
Q: “低频高工单”和“高频低工单”哪种情况更值得做独立文章?A: 通常“低频高工单”的情况更值得投入资源。这类问题虽然搜索量不大,但每次发生都会消耗大量人工成本(高复杂度),且往往代表用户未被解决的深层困惑。解决它能显著降低长期的支持成本。
Q: 工单数据的滞后性会对我们的内容策略造成负面影响吗?A: 不会,只要理解其定位。滞后性决定了它不能作为“实时雷达”,而是作为“趋势罗盘”。它帮助我们验证哪些搜索热点真正转化为了支持成本,从而优化未来的内容布局,避免资源浪费。
参考来源
TicketHub: Enabling Actionable Analysis of Support Requests With NLP · https://dl.acm.org/doi/fullHtml/10.1145⁄3569951.3604397(S级)
Analyzing help center search results · https://support.zendesk.com/hc/en-us/articles/4408818465562-Analyzing-help-center-search-results(B级)
7 Ways to Improve Your Website’s or Intranet’s Built-In Search Engine - NN/G · https://www.nngroup.com/articles/internal-website-search/(B级)