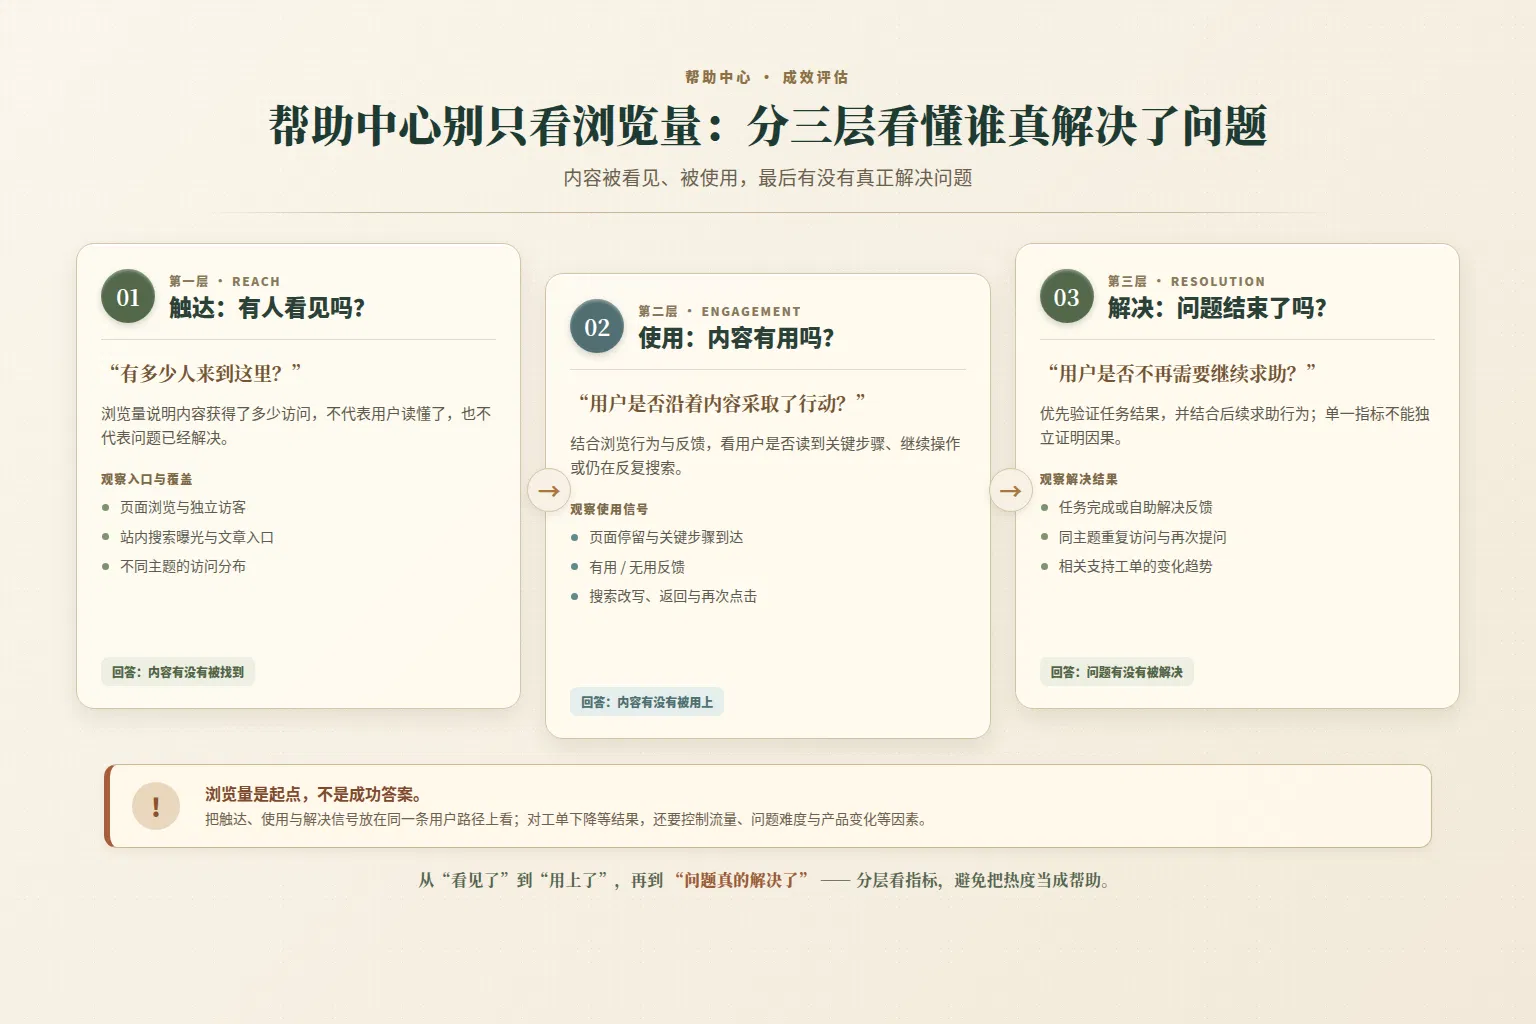
帮助中心指标需分层评估:第一层看页面浏览量确认曝光,第二层通过工单与升级会话验证问题解决,第三层排查过期截图等风险。
本文核心要点速览:
核心观点: 单一的页面浏览量 (Pageview) 指标具有误导性,高流量绝不等于用户问题已解决,它可能掩盖了无效引导。
解决方案框架: 我们提出一个三层体系来全面评估帮助中心:
第一层 需求暴露层: 利用 Pageview 识别用户兴趣点与关注度。
第二层 解决效果层: 通过升级会话、搜索失败记录发现内容缺口。
第三层 内容风险层: 监控版本变更与过期截图,防止错误信息扩散。
关键行动: 运营者需警剔“有搜索结果但无点击”的隐性流失,并优先维护高曝光内容的准确性。
为什么只看一个数字会误判?
单一数字无法区分用户兴趣与实际解决效果,仅凭高访问量会误将‘被看见’等同于‘已解决’,从而掩盖内容无效或误导用户的真相。
高访问量文章,常被误读为“用户满意”或“问题已解决”。这种误判源于把“被看见”直接等同于“已解决”。Zendesk 在 2021 年材料中明确定义 pageview 仅用于识别用户感兴趣的文章及辅助 SEO 判断[1]。该来源并未提供页面浏览与问题解决、内容准确性或客户满意度之间的验证关系[1]。这意味着,pageview 只能回答“哪些文章被看见”,无法单独证明“哪些文章有效”。
当运营者将高曝光量视为高质量时,风险随之放大。高访问文章若内容过期、链接失效或政策描述错误,其负面影响范围反而更大[1]。单纯依赖单一指标,容易遗漏那些搜索失败后离开、或被 AI 错误拦截的用户问题[2][3]。
要构建稳健的评估体系,必须引入分层视角:
需求暴露层:用 pageview 和工单总量识别用户关注点。
解决效果层:通过升级会话、搜索失败记录和任务验证,定位内容缺口[4]。
内容风险层:监控版本变更、重复内容及过期截图等隐患[5]。
这一框架并非单一来源的直接结论,而是基于指标偏差与质量审核证据的综合推导[2][1][3]。只有区分这三层,才能避免被虚假繁荣的数据误导,精准定位真正需要优化的环节。
第一层:需求暴露层——读懂页面浏览量 (pageview) 的真实含义
页面浏览量仅反映文章被用户发现的程度,无法证明问题是否真正解决,两者之间存在巨大的认知鸿沟。
一张帮助中心文章被访问了十万次,这是否代表用户的问题都解决了?未必。这个现象背后,是“被看见”与“已解决”之间的巨大鸿沟。
页浏览量(pageview)本质上是衡量曝光面和兴趣的标尺[1]。在数据稀疏的场景下,它是成本最低、采集最稳的需求信号,几乎不依赖主观判断[1]。Zendesk 将其定义为识别用户感兴趣内容、辅助 SEO 及理解行为的基础指标[1]。但这层指标只回答“哪些文章被看见了”,无法直接证明“哪些文章有效”。高访问量不等于高质量,它仅仅意味着更大的暴露面。
| 指标层级 | 核心问题 | 数据特征 | 适用场景 |
|---|---|---|---|
| 需求暴露层 | 哪些文章被看见? | 稳定、低成本、无主观偏差 | 早期运营、数据稀疏期 |
| 解决效果层 | 问题真没解决? | 波动大、需多源验证 | 成熟期、评估服务质量 |
| 内容风险层 | 有没有隐形错误? | 滞后性、需人工核查 | 版本变更、政策更新时 |
既然 pageview 不能代表满意,该如何利用高曝光文章进行运营?策略很明确:优先维护高 pageview 的内容。因为一旦这些高频访问的文章出现过期截图、失效链接或错误的政策描述,其负面影响会被放大到最大范围[1]。把资源投给没人看的地方是浪费,但把资源投给没人管的高频地方则是灾难。
必须警惕一个逻辑陷阱:将“被访问”直接解读为“用户满意”。数据来源明确指出,页面浏览量本身并不包含问题解决或满意度验证[1]。如果运营者误以为流量高就是效果好,就会忽略那些用户看了文章却因信息错误而被迫转人工工单的事实。这一层的任务,就是诚实地确认流量在哪里,而不是盲目地假设质量达标。
这里存在一个极易被忽视的实操细节:高 Pageview 往往伴随着极高的“无效点击”比例。 很多用户在搜索结果中点击文章,发现标题与预期不符(例如标题是“如何重置密码”,内容却是“密码策略说明”),会在几秒内关闭页面并再次搜索。这种行为在 Pageview 数据上表现为一次成功的“访问”,但在实际体验中是一次失败的“引导”。如果不结合跳出率或停留时长来交叉验证,单纯的高 Pageview 可能会掩盖导航结构混乱或关键词匹配不准的严重问题。因此,在分析第一层数据时,务必将“点击即走”的行为纳入考量,否则你可能会误以为某篇内容是“热门爆款”,实则它是“流量黑洞”。
第二层:解决效果层——从工单到升级会话的缺口发现
工单数据主要衡量团队负荷与趋势,却难以直接验证内容质量,且容易遗漏未提交工单的沉默流失用户。
已解决工单数能告诉你支持团队忙不忙,却很难直接证明你的内容好不好用。Zendesk 在 2021 年的材料里明确指出,监控 solved tickets 有助于评估团队表现、观察趋势并判断资源需求 [3]。但这组数据有个天然盲区:不同工单的处理耗时差异巨大,有的只需几分钟,有的拖了几天 [3]。如果只盯着这个数字,很容易把“问题被人工兜底”误读为“内容足够清晰”。更危险的是,依赖工单会遗漏那些根本没提交工单的用户——他们可能搜索失败后直接离开,或者被 AI 给出的错误答案误导后放弃尝试 [2][3]。这些沉默的流失者,才是内容质量最真实的试金石。
要真正看清解决效果,必须把视线从“已解决的工单”移到“未解决的挣扎”上。升级会话(escalated conversations)就是那盏探照灯。当用户觉得自助服务帮不上忙,选择转接人工时,往往意味着前面的文章没讲透或找不到入口。Intercom Help Center 的案例显示,其 Fin 系统能在识别到需要升级的对话瞬间,发现内容缺口并推荐补全方案 [4]。这种机制证明了升级会话是识别内容盲区的强信号。不过要注意,这套逻辑不能盲目套用到所有平台或语言环境,它只是特定场景下的有效线索 [4]。
单一指标容易失真,多维证据链才能还原真相。我们需要将升级会话、搜索失败记录、文章反馈和任务验证结合起来看。下表展示了不同数据源在识别内容缺口时的侧重点与局限:
| 数据维度 | 核心作用 | 主要局限 | 适用场景 |
|---|---|---|---|
| 升级会话 | 定位用户放弃自助的临界点 | 仅覆盖最终转人工的小部分用户 | 发现深度理解障碍 |
| 搜索失败 | 捕捉用户找不到入口的瞬间 | 无法区分是词不达意还是无结果 | 优化导航与关键词 |
| 文章反馈 | 获取用户对具体内容的直观评价 | 样本量通常较小,存在幸存者偏差 | 验证单篇文章质量 |
| 任务验证 | 确认用户是否真正完成操作目标 | 技术埋点成本高,实施复杂 | 关键流程闭环检查 |
这些线索应当被视为“缺口发现”的依据,而不是自动化的质量判决。它们共同指向一个事实:真正的解决效果,不在于工单被关掉了多少,而在于有多少用户根本不需要打开工单就能完成任务。
为了更精准地定位缺口,建议引入“搜索零结果”与“低点击率搜索词”的对比分析。 很多时候,用户搜索了一个词,系统返回了结果,但用户没有点击任何一篇,而是直接离开了。这比“搜索无结果”更隐蔽,也更致命。它暗示着:系统找到了相关文档,但标题或摘要未能准确传达核心价值,导致用户认为“没用”而放弃。例如,用户搜索“退款流程”,系统返回了一篇《退款政策详解》,但用户实际需要的是“如何申请退款”的操作指南。这种“有结果但无点击”的现象,是第二层指标中最容易被忽略的痛点,它直接指向了内容架构与用户意图的错位。
第三层:内容风险层——版本变更与过期截图的隐形杀手
内容风险层专注于核查信息的时效性与准确性,旨在识别政策错误或过期截图等可能成倍放大负面影响的问题。
高访问量的文章如果存在政策描述错误或链接失效,其负面影响范围会成倍放大[1]。这就是为什么必须单独设立“内容风险层”。这一层不关心有多少人点开了页面,也不在乎工单是否关闭,它只盯着一个核心问题:你提供的信息现在还能用吗?
当产品迭代或政策调整时,旧内容往往被遗忘在角落。过期的截图会让用户以为功能还在,结果在操作中被卡住;错误的政策承诺则可能直接引发合规纠纷。这些隐患不像数据波动那样显眼,却像定时炸弹。特别是 AI 回答源,一旦抓取了错误知识,会在瞬间向成千上万的用户输出误导信息[5]。这种批量化的错误传播,比单个用户的投诉严重得多。
为了看清这三层的区别,我们可以对比不同指标的关注焦点:
| 关注层级 | 核心指标示例 | 主要监控对象 | 典型风险场景 |
|---|---|---|---|
| 需求暴露层 | 页面浏览量 (Pageview) | 流量大小、SEO 效果 | 误判为“已解决”,忽视内容质量 |
| 解决效果层 | 升级会话、搜索失败率 | 任务完成度、缺口发现 | 遗漏未提交工单的沉默用户 |
| 内容风险层 | 版本变更、过期截图、AI 回答 | 准确性、时效性、合规 | 高曝光下的错误信息扩散 |
这张表能帮你理清思路:前两层看的是“人”的行为,而第三层看的是“货”的状态。高曝光文章若包含过期截图,就像在高速公路上贴了错误的限速牌,车流量越大,事故概率越高[2]。
把这三个层次拼在一起,你就得到了完整的评估视图。第一层告诉你哪里有人来,第二层告诉你哪里没修好,第三层则负责排查那些正在腐蚀信任的隐形裂痕。只有同时守住这三道防线,帮助中心才能从单纯的“信息仓库”变成真正可靠的“解决方案库”。
常见问题解答 (FAQ)
Q: 为什么页面浏览量(Pageview)高不代表用户满意?A: Pageview 仅反映用户“看到了”内容,属于需求暴露层的指标。它无法验证用户是否理解了信息、是否成功完成了任务,也无法排除用户因内容错误而被迫联系人工客服的情况。此外,高流量还可能掩盖了“点击即走”的无效引导问题。
Q: 如何准确评估工单解决率?A: 单纯看“已解决工单数”存在盲区,因为它忽略了未提交工单的沉默流失用户。建议结合“升级会话”、“搜索失败记录”以及“任务验证”等多维数据,综合评估自助服务的实际效果,而非仅依赖工单数量。特别要注意那些“有搜索结果但无点击”的隐性流失。
Q: 什么是帮助中心的内容风险层?A: 这是指对信息准确性和时效性的监控层。即使流量很高,如果文章包含过期截图、失效链接或错误的政策描述,都会造成严重的信任危机和合规风险,特别是在 AI 生成内容普及的今天,这种风险会被指数级放大。
参考来源
Using the metrics that matter to improve your knowledge base – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408838548250-Using-the-metrics-that-matter-to-improve-your-knowledge-base(A级)
Measuring Self-Service Success - Consortium for Service Innovation · https://www.serviceinnovation.org/measuring-self-service-success/(A级)
Analyzing the metrics that matter to improve customer support – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408832234394-Analyzing-the-metrics-that-matter-to-improve-customer-support(A级)
Mastering knowledge management for great AI support | Intercom Help · https://www.intercom.com/help/en/articles/11782981-mastering-knowledge-management-for-great-ai-support(A级)
Article Quality Index (AQI) - NiCE Knowledge Success Center · https://expert-help.nice.com/Success/Self-Service_Strategy/KCS_Methodology/AQI(A级)